Whisper X GUI
Nata per far risparmiare ai reparti Social e Amministrazione ore di trascrizione manuale: una pipeline in Python che pulisce l'audio con ffmpeg, trascrive con WhisperX (timestamp a livello di parola) e riconosce chi parla con pyannote. Tutto in locale, su desktop o dal browser con la versione Docker.
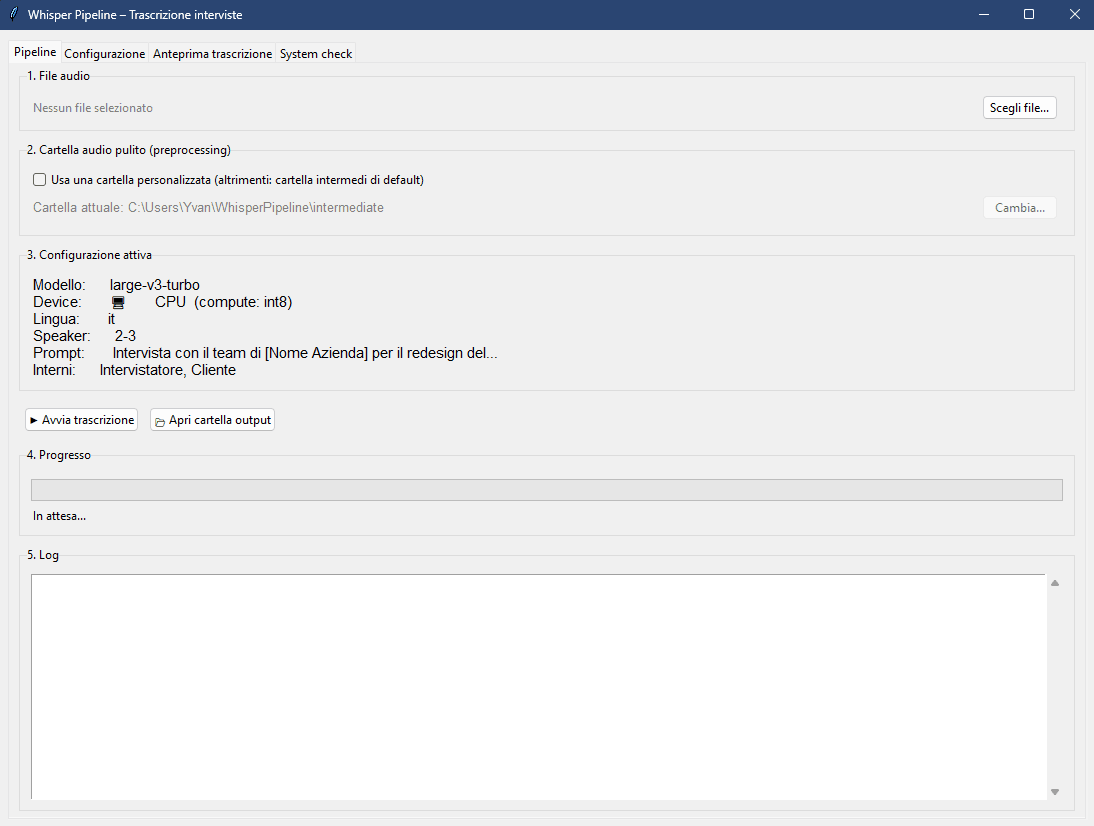
La sfida che ho risolto
Prima la sbobinatura di un audio richiedeva giorni di lavoro: ore di registrazione da riascoltare, fermare e trascrivere a mano. Ora la trascrizione la fa la pipeline — con i timestamp e i nomi di chi parla — e resta solo da ricontrollare il risultato ed eventualmente darlo in pasto all'IA per avere una lista dei punti principali del discorso.
Perché è nato
Il programma è nato per aiutare il reparto Social e quello Amministrativo nella trascrizione degli audio delle riunioni con i clienti e, all’occorrenza, di quelle interne. Prima questa operazione richiedeva ore, a volte giorni di lavoro; ora basta il tempo di elaborazione dell’audio, e la trascrizione può poi essere affidata all’IA per ottenere un riassunto per punti della riunione.
Screenshot
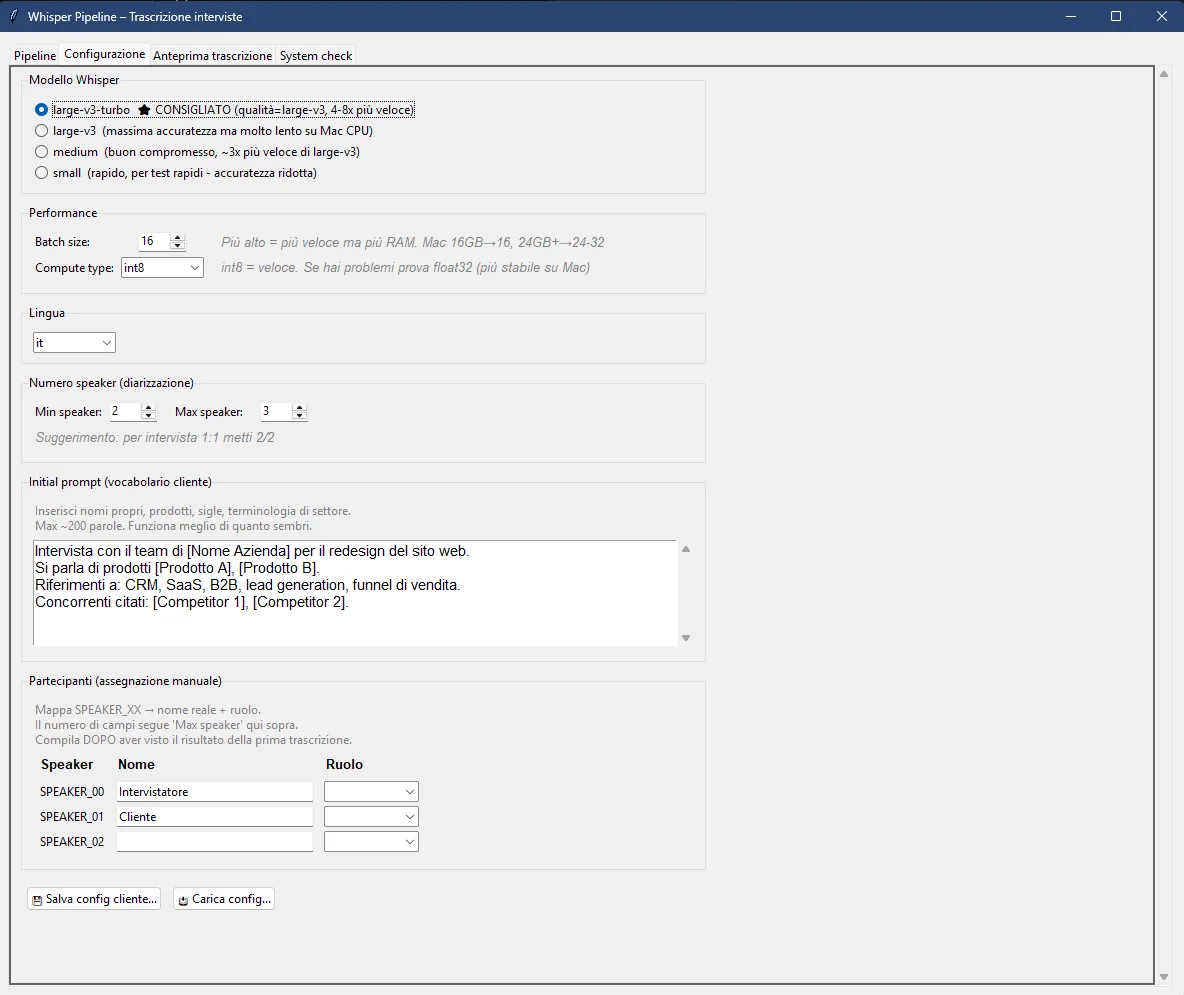 La configurazione: scelta del modello Whisper, numero di speaker per la diarizzazione, vocabolario del cliente (initial prompt) e mappatura degli speaker su nomi reali, con config salvabili per cliente.
 L’anteprima integrata: si può riaprire l’ultima trascrizione o caricarne una esistente senza uscire dall’app.
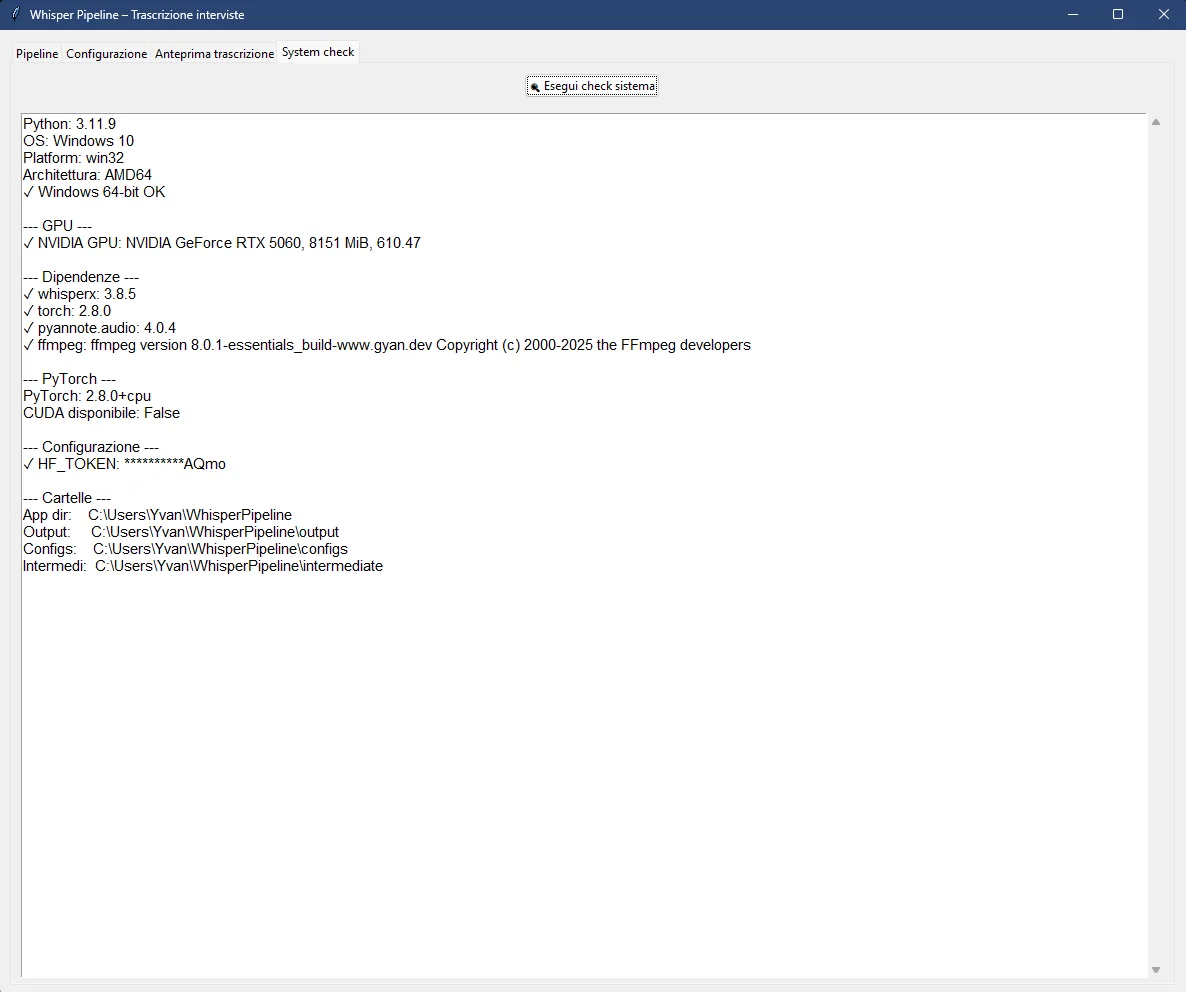 Il system check: verifica Python, GPU, dipendenze (WhisperX, PyTorch, pyannote, ffmpeg), token HuggingFace e cartelle di lavoro.
Tecnologie usate
Il programma è interamente in Python. Python è stato scelto perché tutto l’ecosistema di trascrizione automatica (Whisper, pyannote, PyTorch) vive lì, ed è nato come applicazione desktop con una GUI in tkinter, funzionante sia su macOS che su Windows. Il cuore è una pipeline a stadi: l’audio viene prima pulito con ffmpeg (filtri e normalizzazione del volume), poi trascritto con WhisperX (Whisper, modello large-v3-turbo), i timestamp vengono allineati a livello di parola e infine pyannote.audio riconosce chi sta parlando (diarizzazione). Il risultato viene esportato in Markdown leggibile, JSON completo e SRT per i sottotitoli. Tutto gira in locale, con accelerazione GPU NVIDIA se presente: nessun cloud e nessuna API a pagamento, i modelli si scaricano una sola volta da HuggingFace. Col tempo si è aggiunta una versione Docker pensata per il deploy su un server aziendale: espone un’interfaccia web con le stesse identiche funzionalità della GUI (backend FastAPI, frontend in HTML/JavaScript), così chiunque nella rete può usare il programma dal browser senza installare nulla sul proprio computer.